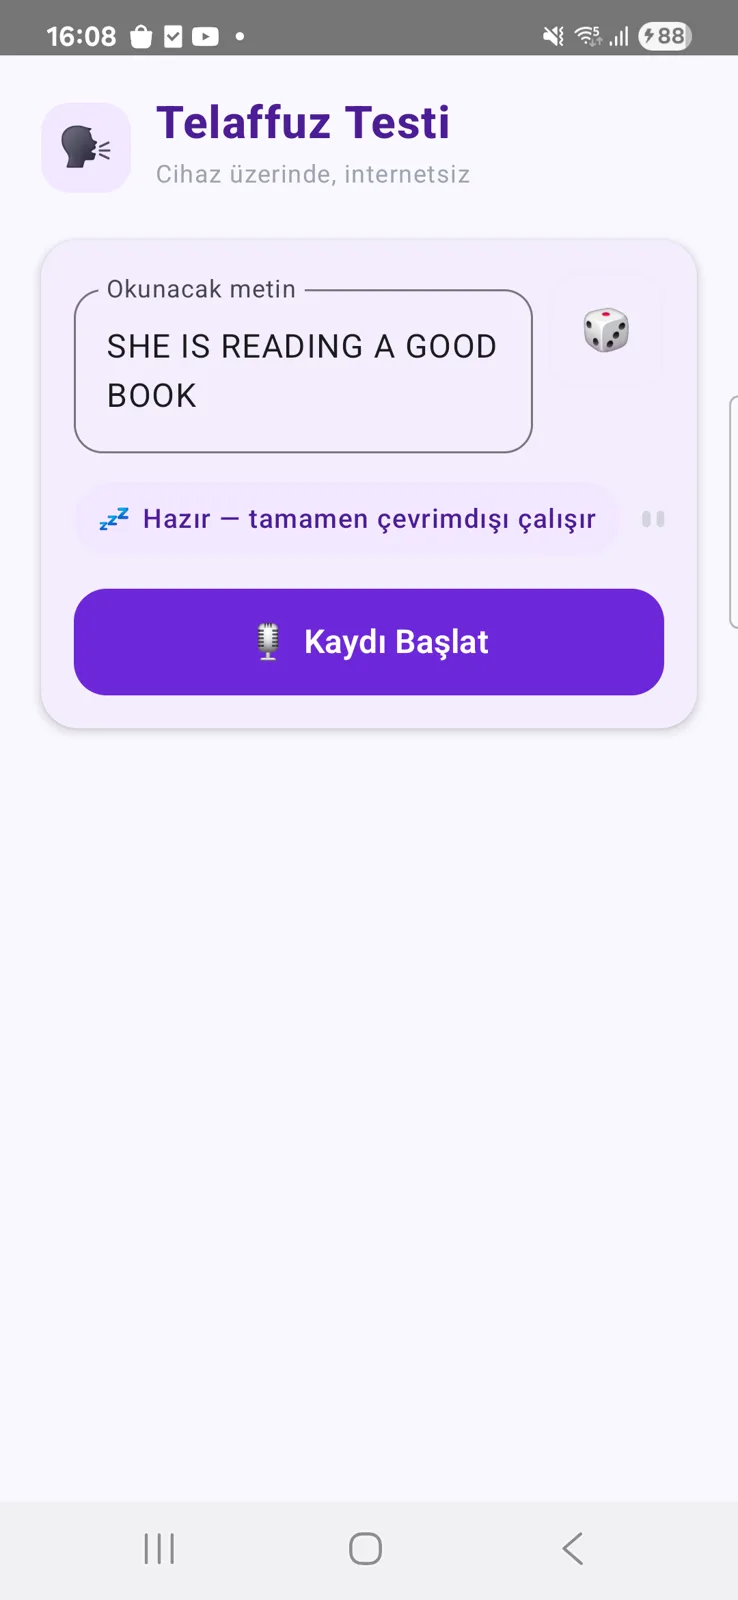
Neden farklı
Çoğu telaffuz uygulaması konuşmayı metne çevirip hedef cümleyle karşılaştırıyor. Bu da ancak “kelime doğru mu” düzeyinde, kaba bir sonuç veriyor. Ben metne çevirmeyi atlayıp akustik modelin ham fonem olasılıklarıyla çalışmak istedim.
Nasıl çalışıyor
ses (16 kHz) → wav2vec2 (ONNX, INT8) → kare başına fonem olasılıkları
                                                  │
hedef cümle → CMUdict → beklenen fonem dizisi     │
                                                  ▼
                        CTC forced alignment (Viterbi, Kotlin)
                                                  │
                                                  ▼
fonem başına güven skoru + "duyulan" ses- Akustik model: wav2vec2 tabanlı, CTC ile eğitilmiş bir fonem modeli, her ~20 ms’lik kare için 38 fonem üzerinde olasılık dağılımı üretiyor.
- Beklenen sesler: Okunacak cümle, ~130 bin kelimelik açık telaffuz sözlüğü CMUdict ile fonem dizisine çevriliyor.
- Hizalama: Olasılık matrisi ile beklenen fonem dizisi, Viterbi dinamik programlamasıyla zaman ekseninde hizalanıyor. Algoritmayı önce Python / torchaudio ile referans alıp doğruladım, sonra cihazda çalışması için Kotlin’de sıfırdan yazdım.
- Skor: Her fonemin hizalandığı aralıktaki ortalama olasılık 0 – 100 arası bir skora dönüşüyor. Kullanıcının aslında ne söylediğini göstermek için fonetik olarak yakın seslerden “karışma grupları” tanımladım; model yalnızca bu küçük aday havuzunda seçim yaptığı için gürültüden anlamsız bir fonem uydurmuyor. Modelin bilinen kör noktaları (cümle başı ve sonu, tek karelik patlamalı sesler) kullanıcıya hata gibi gösterilmiyor.
Cihazda çalıştırma
Model INT8’e nicemlenip ONNX’e aktarıldı ve Android’de ONNX Runtime ile çalışıyor. ~120 MB’lık model dosyasını ilk denemede Java heap’ine okumaya çalıştım ve bellek taşması aldım; dosyayı belleğe eşleyerek (memory-mapped) yüklemeye geçtim. Uygulamanın internet izni bile yok.