Fikir
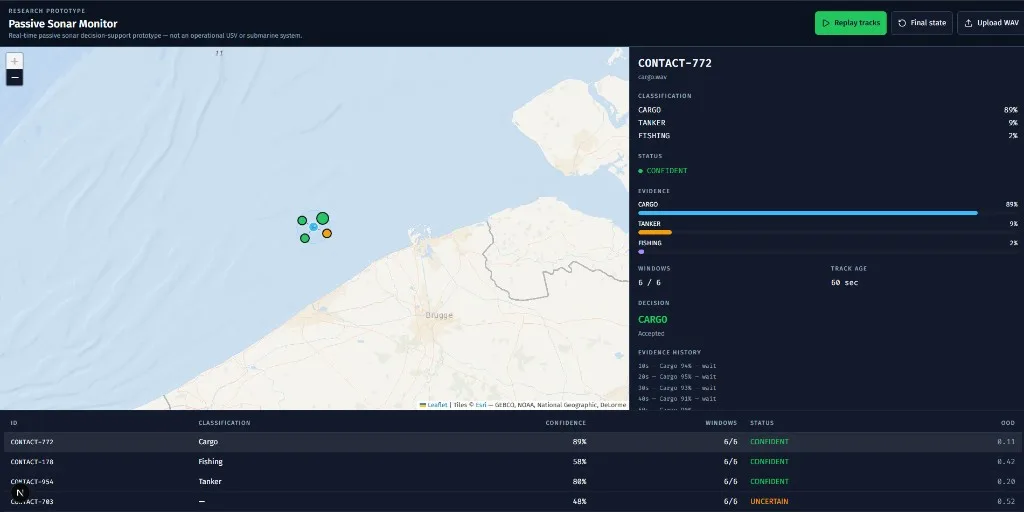
10 saniyelik tek bir ses kesitinden verilen karar zayıf: %60,3 doğruluk. Aynı model bir geminin tüm pencereleri üzerinden ortalandığında doğruluk %83,6’ya çıkıyor. Bu yüzden ürünü “daha sert tahmin” üzerine değil, bir güven kapısı üzerine kurdum:
| Zorunlu sınıflandırıcı | Bu sistem |
|---|---|
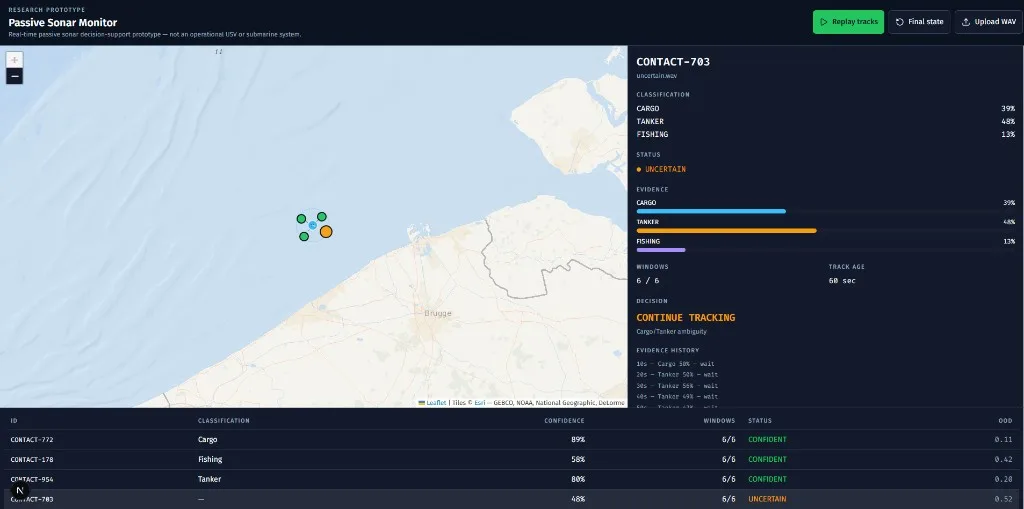
| Kargo 0,43 / Tanker 0,39 → Kargo | BELİRSİZ, takibe devam |
| Kargo 0,89 → Kargo | KARGO, EMİN |
Hat
Hidrofon sesi 10 saniyelik pencerelere bölünüyor, her pencere bir CNN’den geçip üç sınıf olasılığı üretiyor. Olasılıklar temas izi boyunca ortalanıyor. En az 5 pencere birikmeden karar verilmiyor; biriktikten sonra güven kapısı ya bir sınıf ile EMİN ya da BELİRSİZ diyor.
Sonuçlar
61 görülmemiş gemi; eğitim ve testte ortak gemi kimliği (MMSI) yok.
| Ölçüt | Sonuç |
|---|---|
| Kesit doğruluğu | %60,3 |
| Gemi doğruluğu | %83,6 |
| Makro-F1 | 0,719 |
| Çoğunluk tabanı | %75,4 |
| Seçici doğruluk | %92,9, kapsam %68,9 |
%92,9 genel test doğruluğu değil; yalnızca sistemin kabul ettiği temaslardaki performans. Temasların %31,1’i belirsiz olarak geri çevriliyor. Eşikleri test gemilerini puanlamadan önce validasyonda dondurdum.
Veri
VLIZ’in AIS etiketli hidrofon kayıtları (CC-BY-4.0), 3 km’den yakın mesafe. Bölme MMSI’ye göre gruplu; aynı geminin kayıtları hem eğitimde hem testte olamıyor.
Operatör ekranı
FastAPI arka ucu /contacts ve /analyze uç noktalarını sunuyor; Next.js arayüzünde temaslar haritada gösteriliyor, bir WAV dosyası yüklenip analiz edilebiliyor. Haritadaki geometri bir demo; gerçek AIS konumu değil.
Kapsam
Bir karar destek prototipi. Sahada kullanılan bir sistem, denizaltı sınıflandırıcısı ya da hedefleme aracı değil.